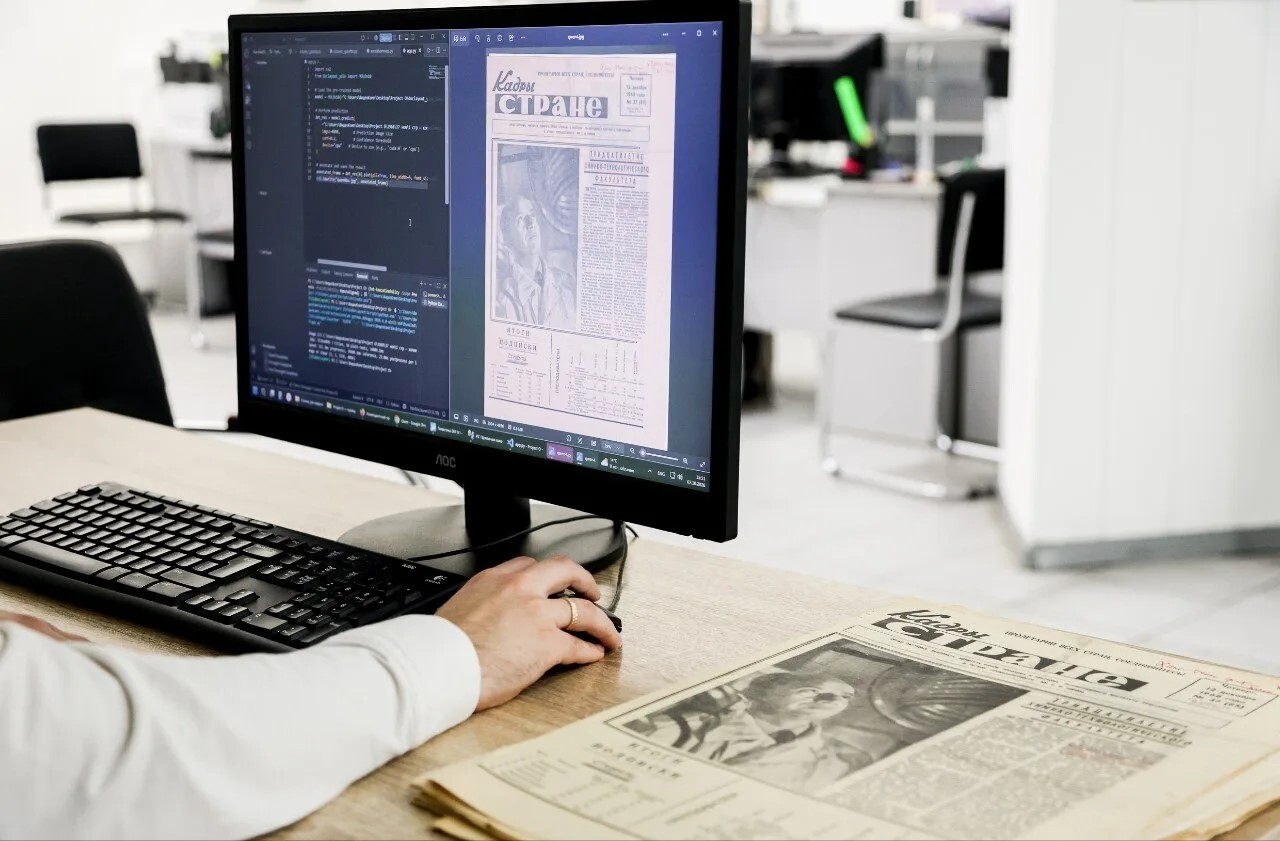
Процесс реставрации происходит поэтапно. Сначала алгоритм сканирует страницу, выделяя смысловые зоны – заголовки, колонки, изображения и таблицы. Затем система проводит цифровую реставрацию: повышает контраст, устраняет микроразрывы в буквах и отделяет шрифт от пожелтевшего фона. После очистки данные поступают в OCR-модуль для распознавания символов.
Финальный аккорд принадлежит собственной крупной языковой модели (LLM) вуза. Она не просто считывает буквы, а анализирует контекст эпохи. Модель дообучали на подшивке институтской газеты «Кадры стране» за 1968 год. Это позволило ИИ выучить специфическую лексику, аббревиатуры и орфографию того времени. Особое достижение – работа с многоколоночной версткой старых газет: нейросеть понимает пространственное расположение текста, правильно объединяет разорванные заголовки и выстраивает логику абзацев.
«Система восстанавливает утраченный текст, сохраняя оригинальный стиль и контекст», – отмечает автор разработки, ассистент кафедры интеллектуальных систем и защиты информации Никита Сиротенко.
Сейчас технология нацелена на помощь архивистам и историкам. Однако в будущем её функционал планируют расширить для нужд криминалистов – восстановления залитых или обгоревших улик, а также для страховых компаний при обработке документов после ЧС.